 首页
 关于我们
 产品中心
 技术服务
 技术中心
 联系我们
导读
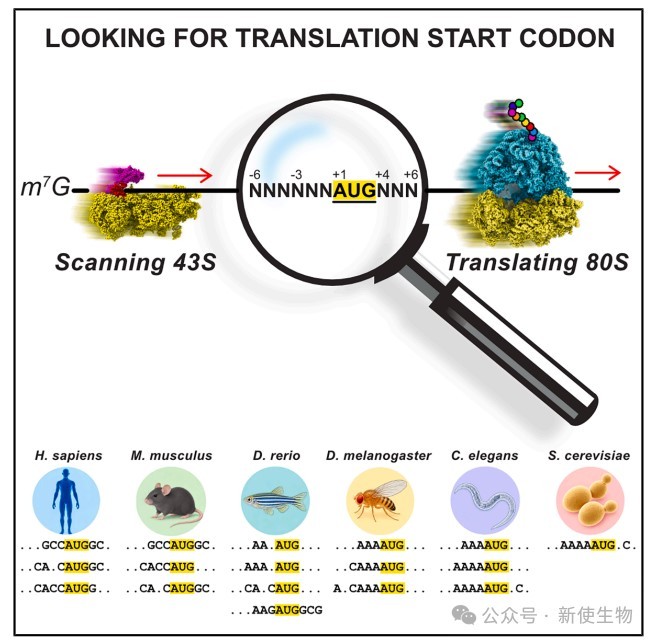
真核生物的翻译起始是一个受到高度调控的复杂过程,涉及信使核糖核酸(mRNA)上的顺式调控序列与多种反式作用因子的协同作用。扫描型43S预起始复合物在mRNA上的起始密码子选择是翻译起始中最关键的步骤,它直接决定了蛋白质的氨基酸序列及其功能。
起始密码子选择的严谨性主要由真核翻译起始因子1(eIF1)、1A(eIF1A)介导,二者通过阻止不稳定的密码子-反密码子相互作用保障翻译准确性。相反,真核翻译起始因子5(eIF5)会降低选择严谨性,这些因子的浓度平衡对控制翻译起始速率至关重要。
早期的研究表明,起始密码子周围的核苷酸环境对起始密码子的识别效率具有显著影响,其中Kozak序列被广泛认为是哺乳动物中起始密码子周围的共有序列。然而,现有的共有序列模型往往基于平均核苷酸频率,忽略了核苷酸之间可能存在的相互依赖性或互斥性,这限制了我们对翻译起始分子机制的深入理解。
2026年9月11日,法国斯特拉斯堡大学Franck Martin团队在Cell Reports上发表了题为“Eukaryotic AUG initiation contexts consist of a broad range of nucleotide patterns associated with distinct biological functions”的研究论文。本研究分析了六种真核生物mRNA中AUG起始密码子的核苷酸上下游,发现其无绝对共有序列,而是以-3位保守嘌呤为核心形成多种组合模式。
文章索引
【标题】Eukaryotic AUG initiation contexts consist of a broad range of nucleotide patterns associated with distinct biological functions
【发表期刊】Cell Reports
【发表日期】2026年9月11日
【作者及团队】法国斯特拉斯堡大学Franck Martin团队
【IF】7.7
研究结果
一、特定核苷酸在真核生物AUG起始上下游中存在相互依赖性
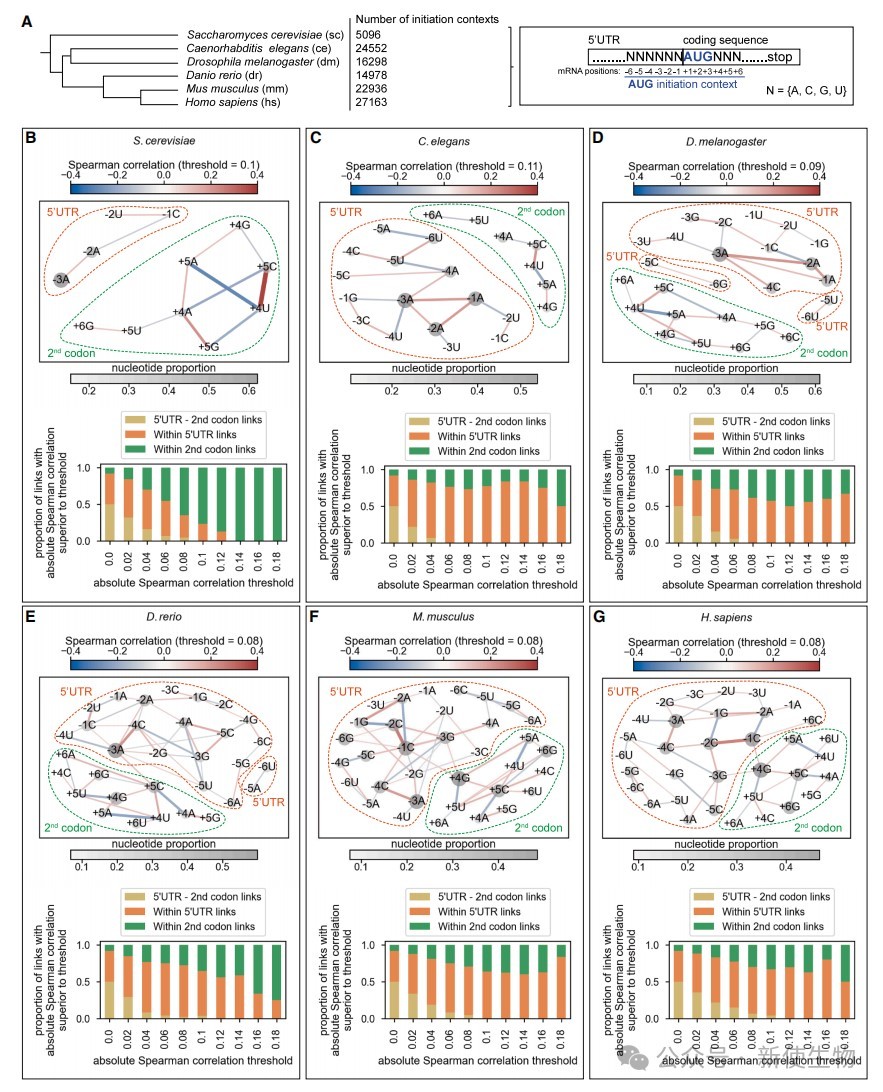
研究者计算了核苷酸频率之间的斯皮尔曼(Spearman)秩相关系数,发现5' UTR与第二个密码子的序列构成了独立的互作网络。
在哺乳动物中经典的Kozak序列可根据-3位嘌呤的不同被进一步拆分为-3A与-3G两种完全独立的保守模式。
二、广泛且丰度相近的核苷酸组合驱动多物种翻译起始
通过统计学基序(motif)比例分析评估非重叠模式的累积占比,发现没有任何单一种类的核苷酸模式占据绝对优势地位。
这一现象说明真核生物在进化中保留了大量丰度均衡的上下游序列,以便提供多层次的翻译调控空间。
三、核心序列基序独立决定AUG的识别有效性
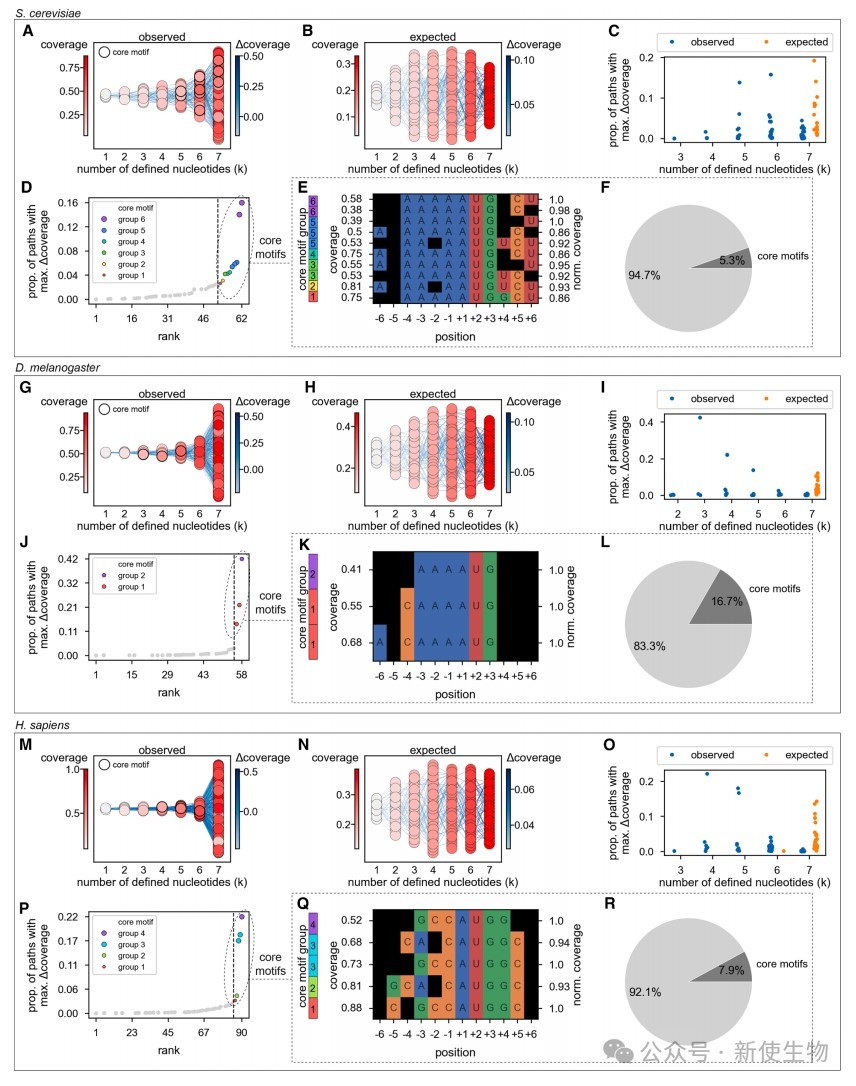
借助于覆盖率动态图谱筛选引发突增的核心基序,发现在缺乏其它位置序列信息的情况下,紧邻AUG的局部核苷酸组合即足以被单独识别。
果蝇等无脊椎动物倾向于依赖富A序列模式,而脊椎动物则演化出高度依赖+4G及C侧翼的复杂组合。
四、整合比例与覆盖率视角鉴定出极少数高置信度共有基序
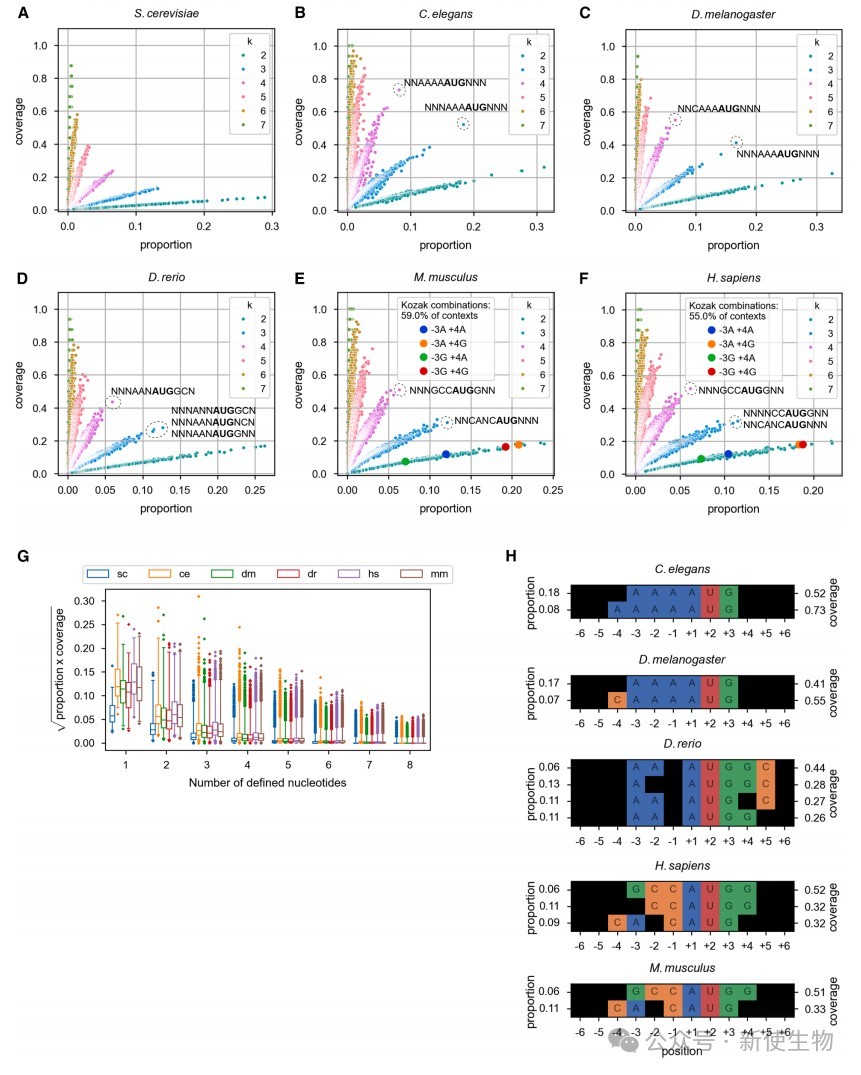
研究团队筛选出能同时实现序列普遍性和高识别包容度的3核苷酸或4核苷酸核心基序,揭示酵母菌和人类等物种在翻译启动机制上的进化分支。
-3位及其侧翼序列的重塑可能是为适应扫描过程中不同的鸟苷三磷酸(GTP)水解时机而产生的特异性改变。
五、-3位嘌呤的侧翼核苷酸极大地决定体外翻译起始效率
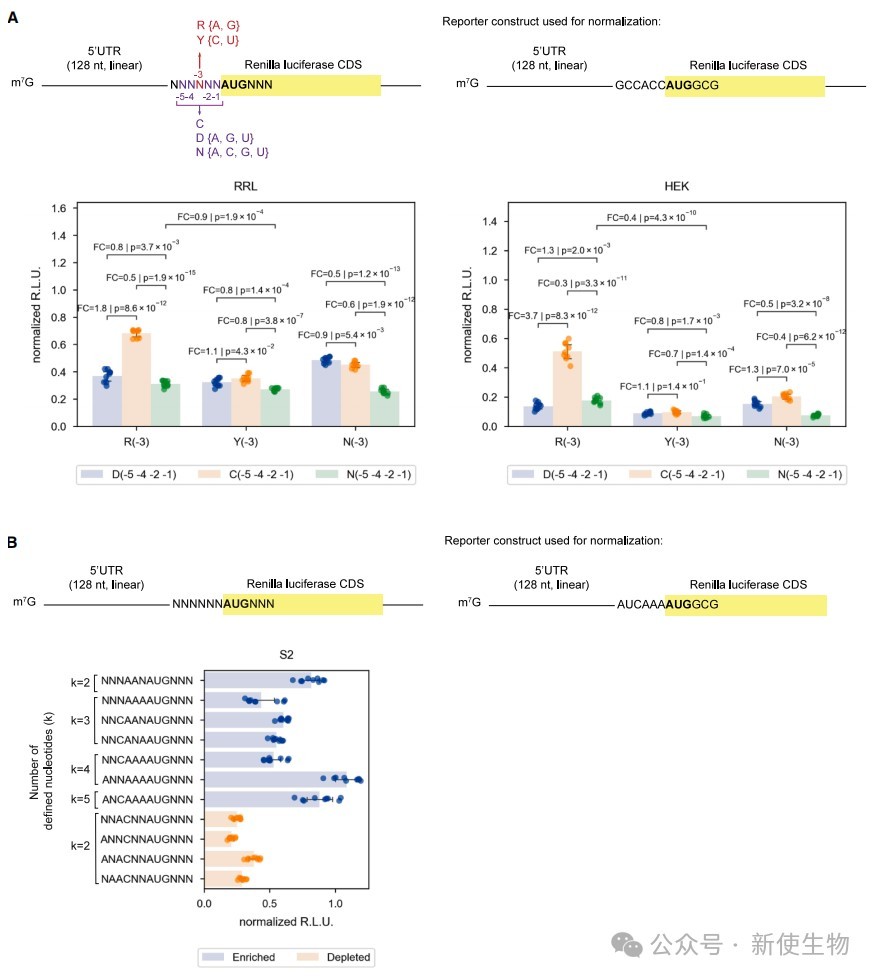
利用兔网织红细胞和HEK293FT细胞提取物进行体外报告基因翻译测试,证实特定序列组合对翻译效率的调控作用。
实验发现仅当-3位嘌呤的上游(-5到-1位)存在C核苷酸时翻译效率才会大幅提升,验证了哺乳动物中复杂侧翼序列的协同增强功能。
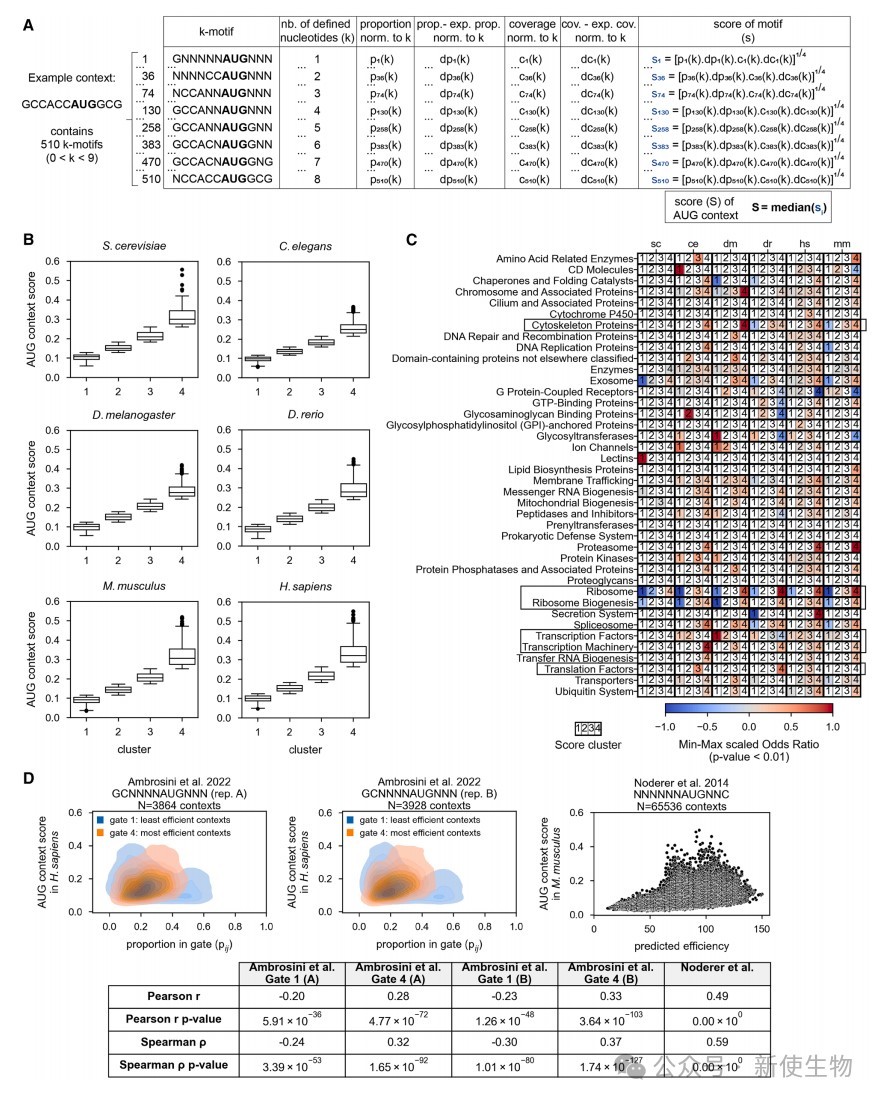
六、物种特异性的AUG上下游评分精准关联特定生物学功能
研究将多重序列特征整合为0到1的打分模型,并通过京都基因与基因组百科全书(KEGG)数据库将不同评分区间与转录本功能进行富集分析。
结果显示核糖体和细胞骨架等核心看家基因富集最高分序列以确保高效表达,而转录因子等调节蛋白则多采用低分序列以便于精细调控。
七、人类主AUG与上游AUG具备迥异序列特征并关联不同功能
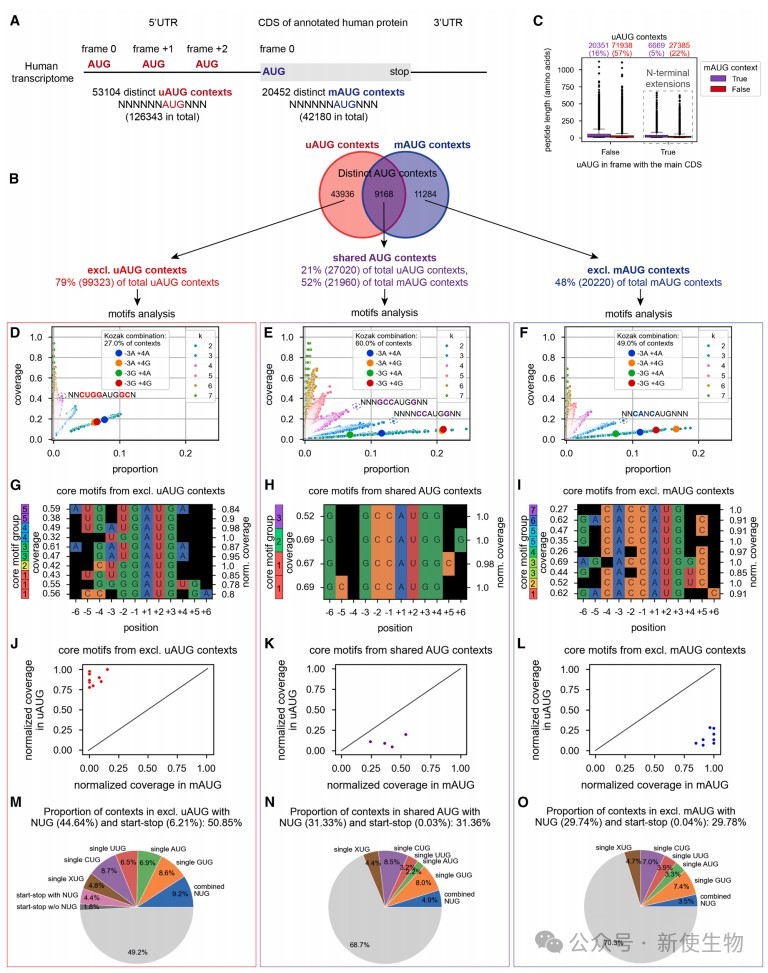
通过比对人类全转录本发现,主开放阅读框(ORF)起点富集-3A关联序列以确保核糖体稳健结合,而上游AUG(uAUG)上下游包含大量非典型密码子。
近半数uAUG发挥着核糖体陷阱的作用,它们主要存在于DNA修复与转录调控相关基因中以实施特异性的翻译抑制。
总结
本研究革新了对于真核生物翻译起始序列的传统认知,证实了多核苷酸间错综复杂的互作网络决定了核糖体对起点的识别偏好。这种兼具高度物种特异性与多维度变化空间的RNA序列模式,为各类细胞功能基因提供了从持续高效表达到精准动态调控的多元化翻译策略。
新使生物专业翻译组学技术平台
新使生物NeoRibo长期专注于翻译组学技术研发与应用,已构建覆盖核糖体翻译、tRNA解码、RNA修饰及Poly(A)尾调控等多个层面的技术体系,提供从整体翻译活性、基因翻译效率到密码子分辨率翻译行为的系统解决方案,全面解析转录后及翻译过程中的精细调控机制。

| 新使生物专业翻译组一站式服务平台 |
| 产品名称 |
GLORI-seq 2.0/3.0 (m⁶A单碱基绝对定量检测) |
